Badanie Apple: LLM rozpoznają aktywność z audio i ruchu
Nowy artykuł Apple pokazuje, jak modele LLM łączą opisy audio i ruchu, by rozpoznawać codzienne czynności przy ograniczonych danych treningowych.
Naukowcy z Apple opublikowali badanie, które sprawdza, w jaki sposób modele LLM mogą analizować dane audio i ruchowe, aby uzyskać lepszy przegląd aktywności użytkownika. Oto szczegóły.
Są w tym dobre, ale nie w przerażający sposób
Nowy artykuł zatytułowany „Using LLMs for Late Multimodal Sensor Fusion for Activity Recognition” rzuca światło na to, jak Apple może rozważać włączenie analizy LLM obok tradycyjnych danych z czujników, aby uzyskać bardziej precyzyjne zrozumienie aktywności użytkownika.
Twierdzą oni, że ma to ogromny potencjał, aby uczynić analizę aktywności bardziej precyzyjną, nawet w sytuacjach, w których brakuje wystarczających danych z czujników.
Od naukowców:
„Strumienie danych z czujników dostarczają cennych informacji na temat działań i kontekstu dla aplikacji podrzędnych, chociaż integracja uzupełniających się informacji może być wyzwaniem. Pokazujemy, że duże modele językowe (LLM) mogą być wykorzystywane do późnej fuzji w celu klasyfikacji aktywności na podstawie danych szeregów czasowych audio i ruchu. Wyselekcjonowaliśmy podzbiór danych do rozpoznawania różnorodnych aktywności w różnych kontekstach (np. czynności domowe, sport) ze zbioru danych Ego4D. Oceniane modele LLM osiągnęły wyniki F1 klasyfikacji 12-klasowej zero- i one-shot znacznie powyżej przypadku, bez szkolenia specyficznego dla zadania. Klasyfikacja zero-shot poprzez fuzję opartą na LLM z modeli specyficznych dla modalności może umożliwić multimodalne aplikacje czasowe, w których istnieje ograniczona ilość wyrównanych danych treningowych do uczenia się wspólnej przestrzeni osadzania. Ponadto fuzja oparta na LLM może umożliwić wdrażanie modeli bez konieczności dodatkowej pamięci i obliczeń dla docelowych multimodalnych modeli specyficznych dla aplikacji”.
Innymi słowy, modele LLM są w rzeczywistości całkiem dobre w wywnioskowaniu, co robi użytkownik, na podstawie podstawowych sygnałów audio i ruchu, nawet jeśli nie są do tego specjalnie przeszkolone. Co więcej, gdy otrzymają tylko jeden przykład, ich dokładność poprawia się jeszcze bardziej.
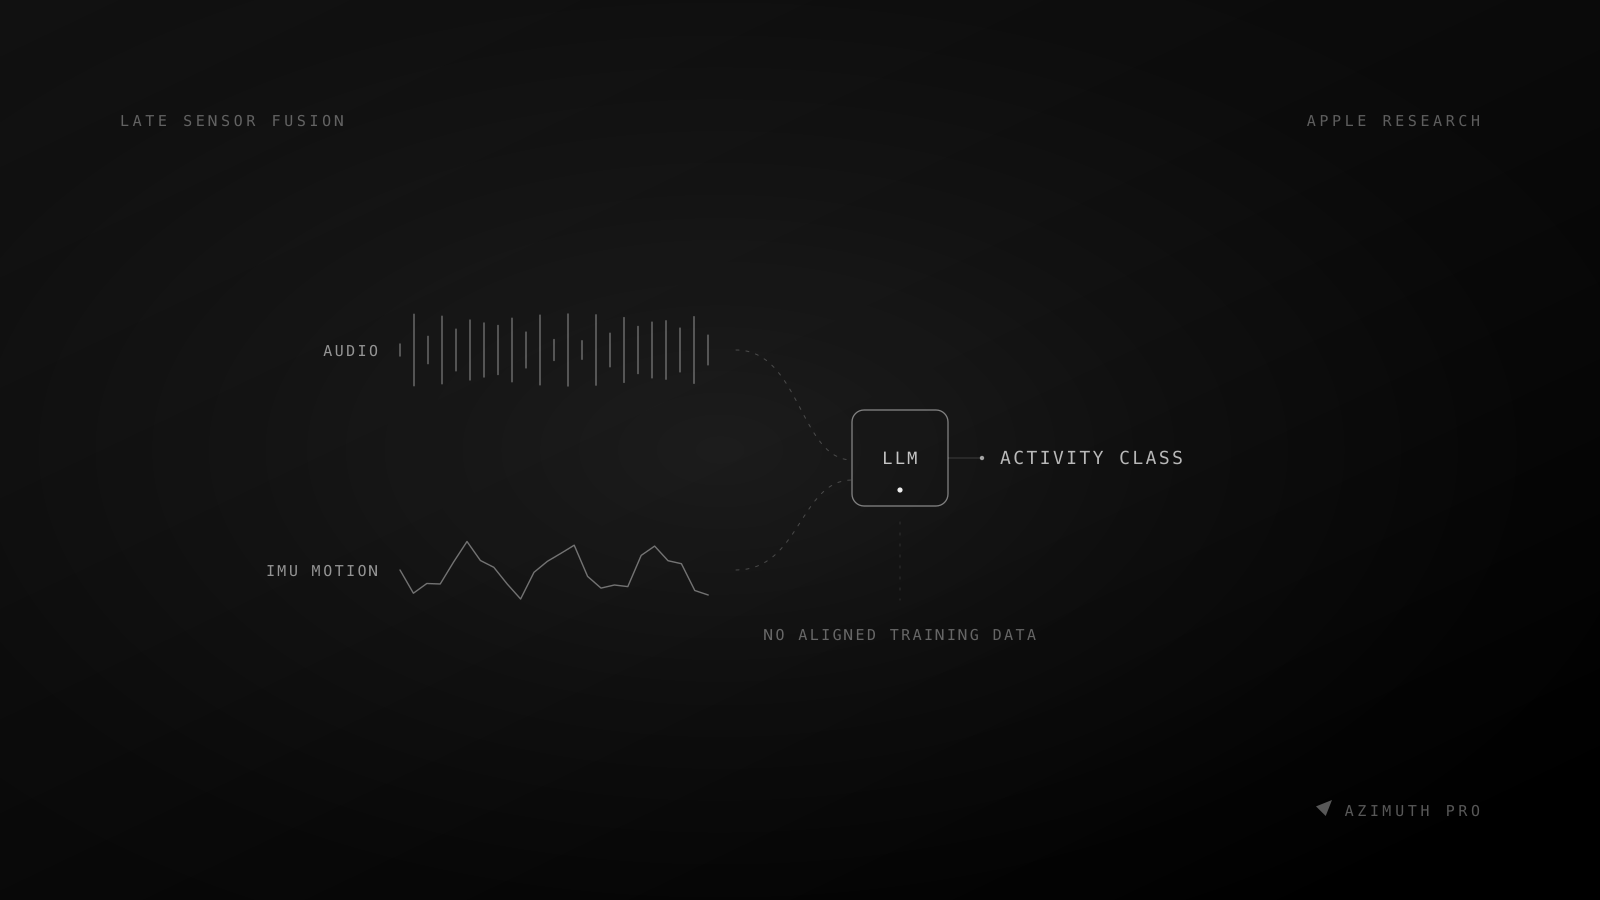
Jednym z ważnych rozróżnień jest to, że w tym badaniu LLM nie otrzymał rzeczywistego nagrania audio, ale raczej krótkie opisy tekstowe wygenerowane przez modele audio i model ruchu oparty na IMU (który śledzi ruch za pomocą akcelerometru i żyroskopu).
Głębsze spojrzenie
W artykule naukowcy wyjaśniają, że wykorzystali Ego4D, ogromny zbiór danych mediów nagranych z perspektywy pierwszej osoby. Dane zawierają tysiące godzin rzeczywistych środowisk i sytuacji, od zadań domowych po zajęcia na świeżym powietrzu.
Z badania:
„Wyselekcjonowaliśmy zbiór danych codziennych czynności ze zbioru danych Ego4D, wyszukując czynności życia codziennego w dostarczonych opisach narracyjnych. Wyselekcjonowany zbiór danych obejmuje 20-sekundowe próbki z dwunastu czynności wysokiego poziomu: odkurzanie, gotowanie, pranie, jedzenie, gra w koszykówkę, gra w piłkę nożną, zabawa ze zwierzętami, czytanie książki, korzystanie z komputera, zmywanie naczyń, oglądanie telewizji, trening/podnoszenie ciężarów. Czynności te zostały wybrane tak, aby obejmowały szereg zadań domowych i fitness oraz w oparciu o ich powszechność w większym zbiorze danych”.
Naukowcy przepuścili dane audio i ruchowe przez mniejsze modele, które generowały napisy tekstowe i przewidywania klas, a następnie wprowadzili te wyniki do różnych modeli LLM (Gemini-2.5-pro i Qwen-32B), aby sprawdzić, jak dobrze potrafią zidentyfikować aktywność.
Następnie Apple porównało wydajność tych modeli w dwóch różnych sytuacjach: jednej, w której otrzymały listę 12 możliwych czynności do wyboru (zbiór zamknięty), i drugiej, w której nie otrzymały żadnych opcji (otwarty).
W każdym teście otrzymywały różne kombinacje napisów audio, etykiet audio, danych przewidywania aktywności IMU i dodatkowego kontekstu.
Ostatecznie naukowcy zauważają, że wyniki tego badania oferują interesujące spostrzeżenia na temat tego, jak łączenie wielu modeli może przynieść korzyści danym o aktywności i zdrowiu, zwłaszcza w przypadkach, gdy same surowe dane z czujników są niewystarczające, aby zapewnić jasny obraz aktywności użytkownika.
Co być może ważniejsze, Apple opublikowało materiały uzupełniające do badania, w tym identyfikatory segmentów Ego4D, znaczniki czasu, podpowiedzi i przykłady one-shot użyte w eksperymentach, aby pomóc naukowcom zainteresowanym odtworzeniem wyników.